این مقاله بخشی از آرشیو تاریخی وبتارگت است و ممکن است بهروز نباشد، بهویژه در موضوعات فنی. پیش از استفاده از مطالب، تاریخ انتشار را بررسی کنید.
اين داستاني است كه قدمت آن به روزهاي اوليه كامپيوتر برميگردد. داستان يك طرح دارد. رقابت و دسيسه دارد و نيز عبور از انبوهي از كشورها و زبانها. در آن ناسازگاري و حل و فصل و يك پايان خوش وجود دارد. اما تمركز اصلي بر روي كاراكترهاي 110 و 116 است. در پايان داستان، همه آنها جاي منحصر به فرد خود را در اين دنيا پيدا ميكنند.
اين داستان تعدادي از آن كاراكترها را از نزديك دنبال خواهد كرد هنگامي كه آنها از وب سرور به مرورگر و در جهت مخالف در حركت هستند. در طول مسير شما بيشتر درباره تاريخچه كاراكتر، مجموعههاي كاراكتري، Unicode و UTF8 اطلاعات پيدا خواهيد كرد، و اينكه چرا علامتهاي سوال و كاراكترهاي استرسدار (accented: علامت تكيهي صدا [بدين شكل’]) عجيب و غريب گاهي در پايگاه دادهها و فايلهاي متني ظاهر ميشوند.
اَسكي (ASCII)
كامپيوترها تنها با اعداد سروكار دارند (0 و 1) نه با حروف، بنابراين مهم است كه همه كامپيوترها بر سر آنكه چه اعدادي نمايش دهنده چه حروفي باشند به توافق برسند.
فرض كنيم كامپيوتر من عدد 1 را براي A، عدد 2 را براي B، عدد 3 را براي C و … و كامپيوتر شما عدد 0 را براي A، عدد 1 را براي B و … استفاده كنند. اگر من پيغام HELLO را براي شما ارسال كنم اعداد 8، 5، 12، 12 و 15 براي شما ارسال ميشوند اما در كامپيوتر شما 8 به معناي I است پس وقتي كامپيوتر شما پيغام را دريافت ميكند آن را به صورت IFMMP نشان ميدهد. براي برقراري ارتباط موثر، ما نياز داريم تا بر سر يك روش استاندارد براي رمزگذاري (encoding) كاراكترها به توافق برسيم.
براي اين منظور، در سال 1960 انجمن استانداردهاي آمريكا يك رمزگذاري 7 بيتي كه American Standard Code for Information Interchange (ASCII) ناميده ميشود، ايجاد كرد. در اين روش رمزگذاري HELLO اعداد 72, 69, 76, 76, 79 است و به صورت ديجيتالي بدين گونه 1001000 1000101 1001100 1001100 1001111 منتقل ميشوند. (يك روش خيلي ساده براي تبديل اعداد از مبناي 10 به مبناي 2 استفاده از ماشين حساب ويندوز است. ماشين حساب ويندوز را اجرا كرده و منوي View گزينه Scientific را علامت بزنيد تا گزينههايي به ماشين حساب اضافه شود. حال عدد مورد نظر خود در مبناي 10 را وارد كنيد و گزينه Bin را كه به معناي باينري است انتخاب كنيد، عدد به صورت باينري به نمايش درميآيد.)
با استفاده از 7 بيت، 128 مقدار ممكن از 0000000 تا 1111111 خواهد بود بنابراين ASCII داراي فضاي كافي براي همه حروف كوچك و بزرگ لاتين همراه با همه رقمها، علائم نقطه گذاری مشترک، فاصلهها (spaces)، تبها (tabs) و كاراكترهاي كنترلي ديگر است. در سال 1968 Lyndon B. Johnson رييس جمهور ايلات متحده آن را رسمي كرد – تمام كامپيوترها بايد ASCII را استفاده و درك كنند.
خودتان آن را امتحان كنيد
بسياري از جدولهاي اَسكي موجود 128 كاراكتر را نمايش ميدهند يا توصيف ميكنند. شما هم ميتوانيد يك جدول اَسكي را آنگونه كه مايليد با كمي CSS، HTML و جاوا اسكريپت بسازيد. كد زير اين كار را انجام ميدهد:
HTML + JavaScript + CSS
<html>
    <body>
        <style type="text/css">
            p {float: left; padding: 0 15px; margin: 0; font-size: 80%;}
        </style>
        <script type="text/javascript">
            for (var i=0; i<128; i++)
            document.writeln ((i%32?'':'<p>') + i + ': ' + String.fromCharCode (i) + '<br>');
        </script>
    </body>
</html>
اين كد جدولي شبيه اين را نشان ميدهد:
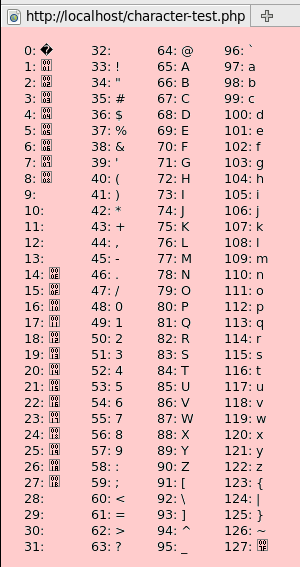
جدول اَسكي توليد شده توسط جاوا اسكريپت در فايرفاكس
قسمت مهم اين كد تابع String.fromCharCode است. اين
تابع يك عدد ميگيريد و آن را به يك كاراكتر تبديل ميكند. در واقع
چهار خط HTML و JavaScript كه در ادامه ميآيند همگي نتيجه يكساني
را توليد ميكنند:
Text
HELLO
& #72;& #69;& #76;& #76;& #79;
<script>document.write ("HELLO");</script>
<script>document.write (String.fromCharCode (72,69,76,76,79));</script>
در خط دوم بايد كاراكتر & چسبيده به # باشد اما چون اگر چسبيده مي نوشتم وردپرس متن را تبديل به HELLO مي كرد. آن را جدا نوشتم كه كد تبديل نشود و شما متوجه منظور خط دوم بشويد.
بيت هشتم
چاپگرهاي راه دور (teleprinter) و بورس از فرستادن 7 بيت از اطلاعات به يكديگر كاملاً راضي بودند اما ريز پردازندههاي نوظهور در 1970 ترجيح ميدادند تا با توانهاي 2 كار كنند. آنها ميتوانستند در يك زمان 8 بيت را پردازش كنند و 8 بيت (يك بايت byte يا octed [گروه هشت تايي]) را براي ذخيره هر كاراكتر مورد استفاده قرار دهند كه 256 مقدار ممكن در دسترس خواهد بود.
يك كاراكتر 8 بيتي ميتواند يك عدد را تا 255 ذخيره كند اما ASCII تنها تا 127 را اختصاص ميدهد. مقادير ديگر از 128 تا 255 يدكي هستند. در ابتدا PCهاي IBM از مقادير يدكي براي نمايش حروف ويژه استرسدار (accented letters)، نمادها و اشكال مختلف و تعدادي از حروف يوناني استفاده ميكرد. به عنوان مثال عدد 200 گوشه پايين سمت چپ يك جعبه بود: ╚، و 244 حرف آلفاي يوناني به صورت كوچك بود: α. به اين روش رمزگذاري حروف نام code page 437 داده شد.
با اين حال بر خلاف ASCII كاراكترهاي 128 تا 255 هرگز به صورت استاندارد درنيامدند و كشورهاي مختلف مقادير يدكي را با الفباي خودشان شروع ميكردند. همه بر سر اينكه 224 بايد α را نشان دهد توافق نداشتند حتي يونانيان. اين منجر به ايجاد تعدادي صفحات كد (code page) جديد شده است. به عنوان مثال در كامپيوترهاي IBM روسيه با استفاده از code page 885، عدد 224 حرف Я را نشان ميدهد. در code page 737 يوناني نشان دهنده امگاي كوچك: ω است.
حتي پس از آن نيز اختلاف نظر وجود داشت. از 1980 ويندوز مايكروسافت كد پيجهاي خاص خود را معرفي كرد. در كد پيج سيريليك (Cyrillic) Windows-1251، عدد 224 حرف a سيريليك را نشان ميدهد و Я، 223 است.
در اواخر 1990 تلاشي در جهت استانداردسازي شكل گرفت. پانزده مجموعه كاراكتري 8 بيتي مختلف براي پوشش دادن الفباهاي گوناگون مانند سيريليك، عربي، عبري، تركي و تايلندي شكل گرفت. آنها ISO-8859-1 تا ISO-8859-16 ناميده شدند (براي شماره 12 هيچ مجموعه كاراكتري قرار داده نشده). در ISO-8859-5 سيريليك، 224 حرف p و 207، Я را نشان ميدهد.
بنابراين اگر يك دوست روسي سندي را براي شما بفرستد، شما در واقع نياز داريد كه بدانيد از چه كد پيجي استفاده شده است. سند به خودي خود يك توالي از اعداد است. كاراكتر 224 ميتواند Я، a يا p باشد. سند با كد پيج اشتباه، شبيه يك دسته از حروف و علائم بهم ريخته ديده ميشود.
خودتان آن را امتحان كنيد
كد پيجها به عنوان مجموعههاي كاراكتري (character sets) شناخته ميشوند. ميتوانيد خودتان اين مجموعههاي كاراكتري را امتحان كنيد اما بايد از PHP يا يك زبان سمت سرور شبيه آن استفاده كنيد (بطور كلي به اين دليل كه كاراكتر نياز دارد قبل از اينكه به مرورگر برسد در صفحه باشد). اين خطوط را در يك فايل PHP ذخيره كرده و آن را به سرورتان آپلود كنيد:
PHP + HTML
<html>
    <head>
        <meta charset="ISO-8859-5">
    </head>
    <body>
        <style type="text/css">p {float: left; padding: 0 15px; margin: 0; font-size: 80%;}</style>
        <?php  for ($i=0; $i<256; $i++) echo ($i%32?'':'<p>') . $i . ': ' . chr ($i) . '<br>'; ?>
        </body>
    </html>
كد بالا جدولي شبيه اين را نمايش ميدهد:
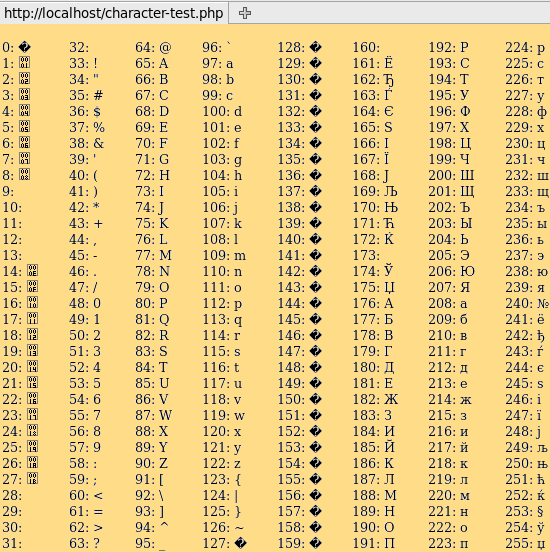
مجموعه كاراكتري سيريليك ISO-8858-5 كه در فايرفاكس به نمايش در آمده
تابع chr در PHP كاري شبيه به همان تابع
String.fromCharCode را در جاوا اسكريپت انجام
ميدهد. براي مثال chr(224) عدد 224 را قبل از ارسال
آن به مرورگر در صفحه وب، قرار ميدهد. چنانكه قبلاً ديديم 224
ميتواند به معناي چيزهاي مختلفي باشد. بنابراين مرورگر نياز دارد
كه بداند از كدام مجموعه كاراكتري براي نمايش 224 استفاده كند. اين
چيزي است كه در خط سوم كد بالا مشخص شده است. اين خط به مرورگر
ميگويد كه از مجموعه كاراكتري سيريليك ISO-8858-5 استفاده كند:
HTML
<meta charset="ISO-8859-5">
اگر خط مربوط به مشخص كردن charset را قرار ندهيد،
صفحه با استفاده از پيش فرض مرورگر به نمايش درميآيد. در كشورهاي
با الفباي مبتني بر لاتين (مانند انگلستان و ایالات متحده)
احتمالاً پيش فرض ISO-8859-1 است كه در اين صورت 224: à است.
اين وضعيت در حدود 1990 است. اسناد در بسياري از زبانها ميتوانند نوشته شده، ذخيره يا رد و بدل شوند اما بايد بدانيد كه از كدام مجموعه كاراكتري در آنها استفاده شده است. همچنين هيچ راه سادهاي براي استفاده دو يا بيشتر از دو الفباي غير انگليسي در همان سند وجود ندارد، و الفباهايي با بيشتر از 256 كاراكتر مثل چيني و ژاپني مجبور به استفاده از سيستمهاي كاملاً متفاوتي هستند.
در نهايت اينترنت در حال ظهور است. بين المللي و جهاني شدن، اين مسأله را بسيار بزرگتر مينمايد. يك استاندارد جديد لازم است.
یونیکد برای نجات
در اواخر 1980 يك استاندارد جديد پيشنهاد شد كه يك شماره منحصر به فرد (كه به طور رسمي به عنوان code point شناخته ميشد) را به هر حرف در هر زبان اختصاص ميداد. در اين روش بيشتر از 256 مقدار مورد نياز بود. اين روش Unicode (يونيكد) ناميده شد. ورژن يونيكد هم اكنون 6.1 و شامل بيش 110000 كد پوينت است. در صورت تمايل ميتوانيد همه آنها را مشاهده كنيد.
128 كد پوينت ابتدايي يونيكد همانند اَسكي هستند. محدوده 128 تا 255 شامل نمادهاي ارز و ساير نمادهاي معمول و كاراكترهاي استرسدار (به عنوان كاراكترهاي با علائم تشخيصي براي تلفظ [diacritical marks] شناخته ميشوند) هستند، و بيشتر آن از ISO-8859-1 گرفته شدهاند. بعد از 256، كاراكترهاي استرسدار بسيار بيشتري قرار دارند. پس از 880 به حروف يوناني ميرسد، سپس سيريليك، عبري، عربي، هندي و تايلندي. چيني، ژاپني و كرهاي از 11904 آغاز ميشوند و بسياري ديگر در اين بين قرار دارند.
اين مهم است كه هر حرف به وسيله شماره منحصر به فرد خود نمايش داده ميشود. حرف Я سيريليكي هميشه 1071 و حرف α يوناني هميشه 945 است. à هميشه 224 و H 72 است. توجه داشته باشيد كه اين كد پوينتهاي يونيكد به طور رسمي به صورت هگزادسيمال با U+ در ابتداي آنها نوشته ميشوند. بنابراين كد پوينت يونيكد H به جاي 72 معمولاً به صورت U+0048 نوشته ميشود ( براي تبديل هگزادسيمال [مبناي شانزده] به دسيمال [مبناي ده] : 72 = 4 * 16 + 8).
مشكل اصلي اين است كه بيشتر از 256 تا از آنها وجود دارد. كاراكترهاي بعد از 256 در 8 بيت جا نخواهند شد. هر چند يونيكد، مجموعه كاراكتري يا كد پيج نيست. بنابراين اين مشكل كنسرسيوم يونيكد نيست. آنها فقط ايده را مطرح كردند و اجازه دادند تا هر كسي پياده سازي خود را انجام دهد.
یونیکد در داخل مرورگر
يونيكد در داخل 8 بيت يا حتي 16 بيت جا نميشود. اگرچه تنها 110116 كد پوينت استفاده شده، قابليت آن را دارد تا 1114112 از آنها تعريف شود كه 21 بيت نياز دارد.
بهرحال كامپيوترها از سال 1970 پيشرفت كرده بودند و يك ريزپردازنده 8 بيتي قديمي شده بود. كامپيوترهاي جديد اكنون پردازندههاي 64 بيتي دارند بنابراين چرا ما نتوانيم از يك كاراكتر 8 بيتي به سمت يك كاراكتر 32 يا 64 بيت برويم؟
نخستين جواب اين است : ما ميتوانيم!
نرمافزارهاي زيادي كه با C يا ++C نوشته شدهاند از كاراكتر عريض
(wide character) پشتيباني ميكنند. اين يك كاراكتر 32 بيتي است كه
wchar_t ناميده شده است. اين يك بسطي از گونه
char، 8 بيتي C است. مرورگرهاي وب مدرن از كاراكترهاي
عريض (يا چيزي شبيه به آن) به صورت داخلي استفاده ميكنند و از
لحاظ تئوري ميتوانند با 4 بيليون كاراكتر متمايز سروكار داشته
باشند. اين مقدار براي يونيكد كفايت ميكند بنابراين
مرورگرهاي وب مدرن به صورت داخلي از يونيكد استفاده
ميكنند.
خودتان آن را امتحان كنيد
كد جاوا اسكريپت زير شبيه كد اَسكي بالا است بجز اينكه كد زير تا مقادير بالاتري ادامه پيدا ميكند. براي هر عدد، كد زير به مرورگر ميگويد تا كد پوينت يونيكد متناظر با آن را نمايش دهد:
HTML + JavaScript + CSS
<html>
    <body>
        <style type="text/css">p {float: left; padding: 0 15px; margin: 0; font-size: 80%;}</style>
        <script type="text/javascript">
            for (var i=0; i < 2096; i++)
            document.writeln ((i%256?'':'<p>') + i + ': ' + String.fromCharCode (i) + '<br>');
        </script>
    </body>
</html>
نتيجه آن جدولي شبيه زير است:
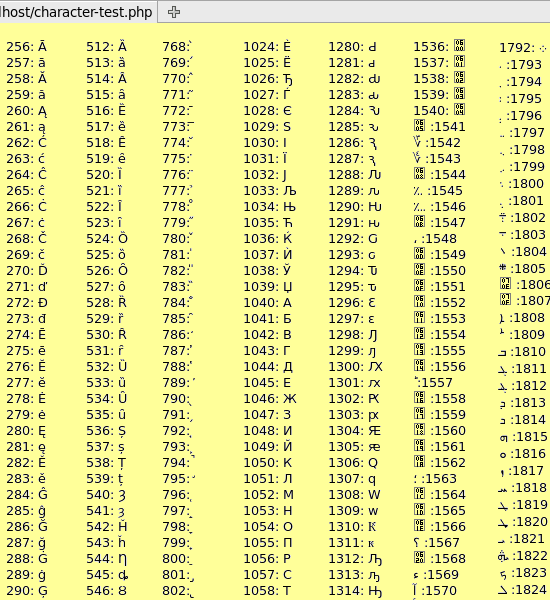
قسمتي از كد پوينتهاي يونيكد كه در فايرفاكس به نمايش در آمده
تصوير بالا تنها زير مجموعهاي از چند هزار كد پوينت خروجي بوسيله
جاوا اسكريپت ميباشد. نكته مهم اين است كه جاوا اسكريپت كاملاً در
مرورگر وب اجرا ميشود جايي كه كاراكترهاي 32 بيتي بطور كامل قابل
پذيرش است. تابع جاوا اسكريپت
String.fromCharCode(1071) كد پوينت يونيكد 1071 را
كه Я است در خروجي نشان ميدهد.
به همين ترتيب اگر شما Я را در يك صفحه HTML قرار
دهيد، مرورگر وب مدرن Я را نشان ميدهد.
از طرف ديگر، تابع پي اچ پي chr(1071) يك اسلش “/” را
نشان ميدهد به خاطر اينكه تابع chr تنها با مقادير 8
بيتي (تا مقدار 256) سروكار دارد و پس از آن خود را تكرار
ميكند.47 = 1071 % 256 كه از سال 1960 يك “/” بوده است.
UTF-8 برای نجات
اگر مرورگرها ميتوانند با كاراكترهاي 32 بيتي يونيكد كار كنند پس مشكل كجاست؟ مشكل در ارسال و دريافت و خواندن و نوشتن كاراكترهاست.
مشكل باقيست چون:
- بسياري از نرمافزارها و پروتكلهاي ارسال/دريافت و خواندن/نوشتن با كاراكترهاي 8 بيتي كار ميكنند
- با استفاده از 32 بيت براي ارسال/ذخيره متن انگليسي مقدار پهناي باند/فضاي موردنياز چهار برابر خواهد شد
هر چند مرورگرها ميتوانند بصورت داخلي با يونيكد كار كنند، هنوز بايد براي مرورگر وب داده را از وب سرور بگيريد و دوباره برگردانيد، و نياز داريد تا آن را در يك فايل يا جايي در يك پايگاه داده ذخيره كنيد. بنابراين هنوز به راهي نياز داريد كه 110000 كد پوينت يونيكد را تنها در 8 بيت جا دهيد.
تلاشهاي مختلفي براي حل اين مسأله انجام گرفته مثل UCS2 و UTF-16. اما در سالهاي اخير UTF-8 برنده بوده است كه مخفف فرمت 8 بيتي انتقال مجموعه كاراكتري جهاني (Universal Character Set Transformation Format 8 bit) است.
UTF-8 باهوش است و نسبتاً شبيه كليد Shift روي كيبورد كار ميكند. به طور معمول هنگامي كه شما H را از كيبورد ميفشاريد حرف كوچك h روي صفحه ظاهر ميشود. اما اگر شما ابتدا Shift را فشار داده باشيد، حرف بزرگ H ظاهر ميشود.
UTF-8 با اعداد 0 تا 127 همانند اَسكي، 192 تا 247 به عنوان كليدهاي Shift و 128 تا 192 به عنوان كليدهايي كه با شيفت استفاده ميشوند، رفتار ميكند. براي مثال كاراكترهاي 208 و 209 شما را به محدوده سيريليك منتقل ميكنند (شيفت ميدهند). 208 همراه با 175 كاراكتر 1071 است كه Я سيريليك ميشود. محاسبه دقيق آن به اين صورت است: 1071 = (64 % 175) + 64 * (32 % 208). كاراكترهاي 224 تا 239 شبيه شيفت مضاعف (double shift) هستند. 226 به دنبال آن 190 و سپس 128 كاراكتر 12160: ⾀ است. 240 به بالا شيفت سه گانه (triple shift) است.
بنابراين UTF-8 يك رمزگذاري با عرض متغير (variable-width) چند بايتي (multi-byte) است. چند بايتي به خاطر اينكه يك كاراكتر واحد شبيه Я بيشتر از يك بايت را براي مشخص شدن ميگيرد. عرض متغير به اين دليل كه برخي از كاراكترها مثل H تنها يك بايت را ميگيرند و برخي تا چهار بايت را اشغال ميكنند.
بهتر از همه اين است كه با ASCII نيز سازگار است. بر خلاف برخي ديگر از راه حلهاي پيشنهادي، هر سندي كه تنها در ASCII با كاراكترهاي 0 تا 127 نوشته شده كاملاً در UTF-8 معتبر است و همچنين موجب صرفه جويي در پهناي باند ميشود.
خودتان آن را امتحان كنيد
اين يك تجربه متفاوت است. PHP شش عدد 72، 208، 175، 226، 190 و 128 را درون يك صفحه HTML قرار ميدهد. مرورگر آن اعداد را به عنوان UTF-8 تفسير ميكند و به صورت داخلي آنها را به كد پوينتهاي يونيكد تبديل ميكند. سپس جاوا اسكريپت مقادير يونيكد را به خروجي ميفرستد. سعي كنيد charset را از UTF-8 به ISO-8859-1 تغيير دهيد و ببينيد چه اتفاقي ميافتد:
PHP + HTML
<html>
    <head>
        <meta charset="UTF-8">
    </head>
    <body>
        <p>Characters embedded in the page:<br>
            <span id="chars"><?php echo chr(72).chr(208).chr(175).chr(226).chr(190).chr(128); ?></span>
            <p>Character values according to Javascript:<br>
                <script type="text/javascript">
                    function ShowCharacters (s) {
                        var r='';
                        for (var i=0; i<s.length; i++)
                        r += s.charCodeAt (i) + ': ' + s.substr (i, 1) + '<br>';
                        return r;
                    }
                    document.writeln (ShowCharacters (document.getElementById('chars').innerHTML));
                </script>
            </body>
        </html>
چيزي كه مشاهده ميكنيد به اين شكل است:
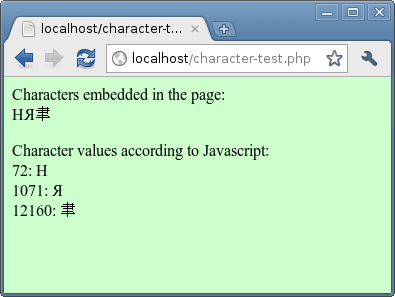
مجموعه كاراكتري UTF-8
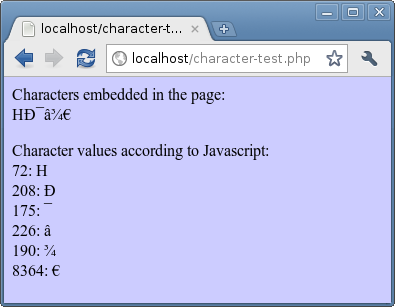
مجموعه كاراكتري ISO-8859-1
اگر صفحه را با استفاده از مجموعه كاراكتري UTF-8 مشاهده كنيد، تنها سه كاراكتر: HЯ⾀ را خواهيد ديد. اگر آن را با مجموعه كاراكتري ISO-8859-1 مشاهده كنيد شش كاراكتر جداگانه: €¾HЯâ را خواهيد ديد. اين چيزي است كه اتفاق ميافتد:
- در وب سرور، PHP اعداد 72، 208، 175، 226، 190 و 128 را درون صفحه وب قرار ميدهد.
- صفحه وب از طريق اينترنت از وب سرور به مرورگر شما ميرسد.
- مرورگر آن اعداد را دريافت و آن را بر اساس مجموعه كاراكتري تفسير ميكند.
- مرورگر به صورت داخلي كاراكترها را با استفاده از مقادير يونيكد نمايش ميدهد.
- جاوا اسكريپت مقادير يونيكد را به مقادير مجموعه كاراكتري ياد شده متناظر ميكند و آنها را به خروجي ميفرستد.
توجه داشته باشيد زماني كه پنج عدد 72، 208، 175، 226، 190 به عنوان ISO-8859-1 مشاهده شوند با كد پوينتهاي يونيكدشان يكسان هستند. اين بدين خاطر است كه در اين محدوده يونيكد به شدت از ISO-8859-1 اقتباس كرده است. بهر حال آخرين عدد كه سمبل € است متفاوت است. اين سمبل در ISO-8859-1 در مكان 128 است و در يونيكد مقدار 8364 را دارد.
خلاصهاي از حدود سالهاي 2003
UTF-8 در حال تبديل شدن به محبوبترين مجموعه كاراكتري بين المللي بر روي اينترنت و جانشيني مجموعههاي تك بايتي (single-byte) مانند ISO-8859-5 است. هنگامي كه شما يك سند غير انگليسي زبان را مشاهده يا ارسال ميكنيد، هنوز هم نياز به دانستن اين داريدكه آن سند از چه مجموعه كاراكتري استفاده ميكند. براي بيشترين قابليت همكاري، مديران وب سايتها نياز دارند تا مطمئن شوند كه همه صفحات وبشان از مجموعههاي كاراكتري UTF-8 استفاده ميكنند.
شايد Ð آشنا به نظر برسد. اين كاراكتر گاهي نمايش داده ميشود اگر شما سعي كنيد تا سندهاي UTF-8 زبان روسي را مشاهده كنيد. بخش بعدي شرح ميدهد كه چگونه مجموعههاي كاراكتري با هم اشتباه گرفته ميشوند و در نهايت همه چيز را به اشتباه در يك پايگاه داده ذخيره ميكنند.
بسیاری از مشکلات
تا زمانی که همه در حال صحبت کردن درباره UTF-8 هستند، همه بايد بدون مشكل كار كنند. اگر اينگونه نباشد كاراكترها ميتوانند خرد شوند. براي توضيح اين كار، يك نمونهي تعامليِ يك وب سايت را تصور كنيد كه همچون يك كاربر، نظري (comment) را در يك پست وبلاگ ميگذاريد.
- صفحه وب يك فرم نظر خواهي را نمايش ميدهد
- كاربر يك نظر را تايپ ميكند و دكمه submit را فشار ميدهد
- آن نظر به سرور فرستاده شده و در پايگاه داده ذخيره شده است
- نظر بعداً از پايگاه داده بازيابي شده و در يك صفحه وب به نمايش در آمده است
اين فرايند ساده ميتواند به طرق مختلف دچار اشكال شود و انواع مشكلات زير را ايجاد نمايد:
HTML ENTITIES
براي لحظهاي وانمود كنيد كه چيزي در مورد مجموعههاي كاراكتري
نميدانيد. فرم در وبلاگتان احتمالاً خود را با استفاده از مجموعه
كاراكتري ISO-8859-1 نشان ميدهد. اين مجموعه كاراكتري، هيچگونه
روسي يا تايلندي يا چيني نميشناسد و تنها مقدار كمي يوناني را
ميشناسد. اگر شما تلاش كنيد تا چيزي را از فرم copy و paste كنيد
و دكمه submit را فشار دهيد، يك مرورگر مدرن سعي خواهد كرد آن را
به entityهاي عددي HTML مثل Я براي كاراكتر Я تبديل
كند.
اين چيزي است كه در پايگاه داده شما ذخيره ميشود و اين چيزي است كه هنگام نمايش يك نظر (comment) در خروجي ظاهر ميشود. بدين معني كه آن نظر، در صفحه وب به درستي نمايش داده ميشود اما زماني كه شما سعي كنيد آن را به يك فايل PDF يا ايميل بفرستيد يا جستجوهاي متني را در پايگاه داده براي يافتن آن اجرا كنيد، مشكلاتي رخ ميدهد.
كاراكترهاي درهم (confused characters)
چه خواهد شد اگر شما با يك وب سايت روسي كار كنيد و يك مجموعه كاراكتري معين در صفحه وبتان نداشته باشيد؟ يك كاربر روسي را كه مجموعه كاراكتري پيش فرضش ISO-8859-5 است در نظر بگيريد. براي گفتن “hi” او ممكن است Привет را تايپ كند. وقتي كاربر دكمه Submit را فشار ميدهد، كاراكترها بر اساس مجموعه كاراكتري صفحه فرستاده شده، كدگذاري (encode) ميشوند. در اين مورد، Привет به صورت اعداد 191، 224، 216، 210، 213 و 226 كدگذاري ميشود. اين اعداد از طريق اينترنت به سرور فرستاده شده و به همين صورت در پايگاه داده ذخيره ميشوند.
اگر بعداً كسي آن نظر (comment) را با استفاده از ISO-8859-5 مشاهده كند، متن را به درستي خواهد ديد. اما اگر آن را با مجموعه كاراكتري ديگري مثل Windows-1251 ببيند، їаШТХв را مشاهده خواهد كرد. اين متن هنوز روسي است اما معني درست را نميرساند و هيچ حسي ايجاد نميكند.
كاراكترهاي استرسدار (accented: علامت تكيهي صدا [بدين شكل’]) با تعداد زيادي از حروف صدادار (:vowel حروف a، e، i، o، u و گاهي y)
اگر شخصي همان كامنت را با استفاده از ISO-8859-1 مشاهده كند، ¿àØÒÕâ را به جاي Привет خواهد ديد. يك عبارت طولانيتر شبيه Я тоже рада Вас видеть (“nice to see you” به شكل رسمي خطاب به يك خانم) وقتي با ISO-8859-5 كدگذاري شود در مجموعه كاراكتري ISO-8859-1 اينگونه نشان داده ميشود: Ï âÞÖÕ àÐÔÐ. اين بدين علت است كه محدوده 128 تا 255 در ISO-8859-1 شامل تعداد زيادي از حروف صدا دار با استرسها (accent) هستند.
بنابراين اگر شما اين نوع الگو را مشاهده ميكنيد، احتمالاً بدين خاطر است كه متن با يكي از مجموعههاي كاراكتري تك بايتي (single byte) (يكي از ISO-8859ها مثلاً ISO-8859-5 يا يكي از Windowsها مثلاً Windows-1251) وارد شده است و در حال حاضر با ISO-8859-1 به نمايش در آمده است. براي درست كردن متن احتياج داريد كه تعيين كنيد كه متن با كدام مجموعه كاراكتري وارد شده و به جاي آن، متن را با UTF-8 وارد كنيد.
كاراكترهاي استرسدارِ تبديل (alternating)
اگر كاربر كامنت را در UTF-8 ارائه كند چه اتفاقي ميافتد؟ در آن صورت كاراكترهاي سيريليك كه كلمه Привет را تشكيل ميدهند هر كدام به صورت 2 عدد فرستاده ميشوند: 208/159، 209/128، 208/184، 208/178، 208/181 و 209/130. اگر آن را تحت ISO-8859-1 مشاهده كنيد شبيه اين ديده ميشود: Привет.
به كاراكترهاي Ð و Ñ توجه كنيد. اين كاراكترها شمارههاي 208 و 209 هستند و به UTF-8 ميگويند تا به محدوده سيريليك سوييچ كند. بنابراين اگر شما تعداد زيادي Ð و Ñ ميبينيد، ميتوانيد فرض كنيد كه در حال نگاه كردن به يك متن روسي هستيد كه در UTF-8 وارد شده و با ISO-8859-1 ديده ميشود. به طور مشابه، يوناني تعداد زيادي Î و Ï، 206 و 207 را خواهد داشت. و عبري، كاراكتر تبديل × به شماره 215 را دارد.
حروف صدا دار قبل از علامت پوند و كپي رايت
يك موضوع رايج در بريتانيا علامت پول پوند (£) است كه به £ تبديل ميشود. اين دقيقاً همان مسالهاي است كه در بالا پيش آمد. مقدار سمبل £ در يونيكد و ISO-8859-1، 163 است. به ياد بياوريد كه در UTF-8 هر كاراكتر بيشتر از 127 به وسيله توالي دو يا بيشتر از اعداد نشان داده ميشود. در اين مورد، توالي UTF-8، 194/163 است. دليل رياضي آن اين است كه : 163 = (64 % 163) + 64 * (32 % 194).
از لحاظ ديداري اين بدين معني است كه اگر شما توالي UTF-8 را با استفاده از ISO-8859-1 مشاهده كنيد، يك Â نمايان ميشود كه كاراكتر 194 در ISO-8859-1 است. اين همان چيزي است كه براي همه كد پوينتهاي 161 تا 191 يونيكد اتفاق ميافتد كه شامل © و ® و ¥ ميشود.
پس اگر در كنار كاراكترهاي £ يا © ناگهان يك Â را ظاهر شد به خاطر اين است كه آنها به عنوان UTF-8 وارد شدهاند.
علامتهاي سوال داخل لوزيهاي سياه
اگر Привет را به عنوان ISO-8859-5 وارد كنيد به عنوان اعدادي كه در بالا ذكر شد ذخيره خواهد شد: 191، 224 و غيره. اگر بعداً سعي كنيد اين را تحت UTF-8 ببينيد ممكن است تعدادي علامت سوال داخل لوزيهاي سياه ببينيد: �. مرورگر زماني اينها را نشان ميدهد كه نميتواند مفهوم اعدادي را كه در حال خواندنشان است، دريابد.
UTF-8 خود-همگامساز (self-synchronizing) است. بر خلاف ديگر رمزگذاريهاي كاراكتري چند بايتي، با UTF-8 هميشه ميدانيد كه در چه موقعيتي قرار داريد. اگر يك عدد 192-247 را ببينيد شما ميفهميد در ابتداي يك توالي چند بايتي قرار داريد. اگر 128-191 را ببينيد، ميفهميد كه در ميانه يكي از آنها قرار داريد.
هيچ خطري در از دست دادن عدد اول و تحريف (garbling) بقيه متن وجود ندارد. به اين معني كه در UTF-8، توالي 191 و پس از آن 224 هرگز به طور طبيعي رخ نخواهد داد، بنابراين مرورگر نميداند با اين چه كند و در عوض �� را نشان ميدهد.
اين همچنين ميتواند باعث مشكلات مربوط به £ و © شود. £50در ISO-8859-1 اعداد 163، 53 و 48 است. 53 و 48 هيچ مسالهاي ايجاد نميكنند اما در UTF-8، 163 هرگز به خودي خود اتفاق نميافتد بنابراين به شكل �50 نشان داده ميشود. بطور مشابه اگر �2012 را ببينيد احتمالاً به خاطر اين است كه ©2012 به عنوان ISO-8859-1 وارد شده اما به عنوان UTF-8 نشان داده شده است.
جاهاي خالي (blank)، علامتهاي سوال و جعبهها
با وجود اينكه UTF-8 و يونيكد كاملاً سودمند و موثر هستند، يك مرورگر هنوز ممكن است نداند كه چگونه يك كاراكتر را نمايش دهد. چند كاراكتر ابتدايي ASCII 1 تا 31 بيشتر تواليهايي براي كنترل teleprinterها (چيزهايي مثل تاييد و توقف) هستند. اگر سعي در نشان دادن آنها كنيد، يك مرورگر ممكن است يك ? يا يك جاي خالي يا يك جعبه با اعداد ريز داخل آن را نشان دهد.
همچنين يونيكد بيش از 110000 كاراكتر را تعريف ميكند. مرورگر شما ممكن است فونت صحيح براي نمايش همه آنها را نداشته باشد. شماري از كاراكترهاي نامفهومتر ممكن است به عنوان ? يا جاي خالي يا يك جعبه كوچك به نمايش درآيد. مرورگرهاي قديمي، ممكن است حتي كاراكترهاي نسبتاً شايع غير انگليسي را به عنوان جعبه نشان دهند.
مرورگرهاي قديمي همچنين ممكن است بيشتر اوقات براي برخي موارد فوق نظير نمايش ?، جاهاي خالي و جعبهها متفاوت رفتار كنند.
پايگاه دادهها
بحث بالا از مرحله مياني از فرايند ذخيره داده در پايگاه داده خودداري كرده است. پايگاه دادههايي مثل MySQL نيز ميتوانند يك مجموعه كاراكتري را براي يك پايگاه داده، جدول يا ستون مشخص كنند. اما اين از مЬموعههاي كاراكتري صفحات وب اهميت كمتري دارد.
هنگام ذخيره و بازيابي داده، MySQL تنها با اعداد سروكار دارد. اگر به آن بگوييد عدد 163 را ذخيره كند، ذخيره خواهد شد. اگر 208/159 را به آن بدهيد MySQL هر دوي آن اعداد را ذخيره خواهد كرد. و هنگام بازيابي داده، شما همان دو عدد را دريافت ميكنيد.
هنگامي كه شما از توابع پايگاه داده براي مقايسه، تبديل و اندازهگيري داده استفاده ميكنيد، مجموعه كاراكتري مهمتر ميشود. براي مثال LENGTH طول يك فيلد به مجموعه كاراكترياش وابسته است، و همچنين مقايسههاي رشتهاي با استفاده از LIKE و = . متدي كه براي مقايسه رشتهها استفاده ميشود collation نام دارد.
مجموعههاي كاراكتري و مقايسه (collation)ها در MySQL يك موضوع جامع است. اين به سادگيِ يك مورد از تغيير مجموعه كاراكتري يك جدول به UTF-8 نيست. بيشتر دستورات SQL اطمينان از اينكه داده در فرمت مناسب نيز وارد و خارج ميشود را در نظر ميگيرند. اين وبلاگنقطه شروع خوبي است.
خودتان آن را امتحان كنيد
كد PHP و جاوا اسكرسپت زير به شما اجازه ميدهد تا تمام اين موضوعات را امتحان كنيد. ميتوانيد مشخص كنيد كه كدام مجموعه كاراكتري براي ورود و خروج متن مورد استفاده قرار ميگيرد، و همچنين ميتوانيد ببينيد كه مرورگر در مورد آن چه فكر ميكند.
PHP + HTML
<?php
$charsets = array('ISO-8859-1', 'ISO-8859-5', 'Windows-1251', 'ISO-8859-7', 'UTF-8');
$charset = isset($_POST['charset']) && is_string($_POST['charset'])
    && in_array($_POST['charset'], $charsets, true)
    ? $_POST['charset'] : 'ISO-8859-1';
$lastcharset = isset($_POST['lastcharset']) && is_string($_POST['lastcharset'])
    && in_array($_POST['lastcharset'], $charsets, true)
    ? $_POST['lastcharset'] : '';
$string = isset($_POST['string']) && is_string($_POST['string']) ? $_POST['string'] : '';
function escapeHtml($value) {
    // Escape HTML syntax while preserving the original bytes of this encoding demo.
    return htmlspecialchars($value, ENT_QUOTES, 'ISO-8859-1');
}
if ($string) {
    echo '<p>This is what PHP thinks you entered:<br>';
    for ($i=0; $i<strlen($string); $i++) {$c=substr ($string,$i,1); echo ord ($c).': '.escapeHtml($c).' <br/>';}
}
?>
<html>
    <head>
        <meta charset="<?=$charset?>">
    </head>
    <body>
        <form method="post">
            <input name="lastcharset" type="hidden" value="<?php echo $charset?>"/>
            Form was submitted as: <?php echo escapeHtml($lastcharset)?><br/>
            Text is displayed as: <?php echo $charset?><br/>
            Text will be submitted as: <?php echo $charset?><br/>
            Copy and paste or type here:
            <input name="string" type="text" size="20" value="<?php echo escapeHtml($string)?>"/><br/>
            Next page will display as:
            <select name="charset"><option>ISO-8859-1<option>ISO-8859-5
                        <option>Windows-1251<option>ISO-8859-7<option>UTF-8</select><br/>
                                <input type="submit" value="Submit" onclick="ShowCharacters (this.form.string.value); return 1;"/>
                            </form>
                            <script type="text/javascript">
                                function ShowCharacters (s) {
                                    var r='You entered:';
                                    for (var i=0; i<s.length; i++) r += '\n' + s.charCodeAt (i) + ': ' + s.substr (i, 1);
                                    alert (r);
                                }
                            </script>
                        </body>
                    </html>
اين مثالي از يك كد به صورت عملي است. اين كد هنگام اجرا مقادير عددي هر يك از كاراكترها و نمايششان (وقتي به صورت تكي ديده ميشوند) را در مجموعه كاراكتري جاري نشان ميدهد.
ميتوانيد از اين كد استفاده كنيد تا سريعاً ببينيد چگونه متن از هم تفكيك ميشود. براي مثال اگر هنگام اجرای اين نمونه دوباره دكمه Submit را فشار دهيد، � داراي كد پوينتِ يونيكد 65533 است كه معادل 239/191/189 در UTF-8 است و به صورت �50 در ISO-8859-1 نشان داده ميشود. بنابراين اگر هميشه نمادهاي £ شما تبديل به � ميشود، به خاطر مسير و روشي است كه از آن طريق دريافت شدهاند.
توجه داشته باشيد كه در كد بالا select box كه در پايين صفحه قرار گرفته در هر بار تغيير دوباره مقدارش به ISO-8859-1 باز ميگردد.
يك راه حل
تمام مشكلات رمزگذاري بالا به اين خاطر است كه متن در يك مجموعه كاراكتري ثبت ميشود و در مجموعه كاراكتري ديگري مشاهده ميشود. راه حل اين است كه اطمينان حاصل كنيد هر صفحه در وب سايتتان از UTF-8 استفاده ميكند. ميتوانيد اين كار را با يكي از خطوط زير كه بلافاصله پس از تگ head ميآيد، انجام دهيد
HTML
<meta charset="UTF-8">
<meta http-equiv="Content-type" content="text/html; charset=UTF-8">
اين كد بايد يكي از اولين چيزها در صفحه وبتان باشد، به اين دليل كه باعث خواهد شد مرورگر تمامِ صفحه را بازبيني كند. به خاطر سرعت و كارايي، مرورگر بايد اين كار را در سريعترين زمان ممكن انجام دهد.
همچنين ميتوانيد UTF-8 را در جدولهاي MySQL مشخص كنيد، هر چند براي استفاده كامل از اين ويژگي، نياز به جستجوي بيشتر در اين باره داريد.
توجه داشته باشيد كه كاربران هنوز ميتوانند مجموعه كاراكتري را در مرورگرهايشان ناديده بگيرند. اين موضوع نادر است اما به اين معنا است كه اين راه حلي تضمين شده نيست. براي امنيت بيشتر، ميتوانيد در مرحله پاياني يك بررسي را براي اطمينان از اينكه داده به شكل صحيح وارد شده است انجام دهيد.
وب سايتهاي موجود
اگر وب سايت شما پيش از اين متن را به زبانهاي گوناگون جمع آوري ميكرده پس نياز به تبديل داده موجود به UTF-8 خواهيد داشت. اگر در سايت شما متنهايي با زبانهاي مختلف وجود ندارد ميتوانيد از يك صفحه PHP شبيه هماني كه در بالا آمد براي تعيين مجموعه كاراكتري اصلي استفاده كنيد و از مرورگر براي تبديل داده به UTF-8 استفاده كنيد.
اگر مقدار زيادي داده در مجموعههاي كاراكتري مختلف داشته باشيد،
نياز داريد تا ابتدا مجموعه كاراكتري را پيدا كنيد و سپس آن را
تبديل نماييد. در PHP ميتوانيد از
mb_detect_encoding
براي پيدا كردن و از
iconv
براي تبديل استفاده كنيد. هنگام خواندن توضيحات
mb_detect_encoding به نظر ميرسد كاملاً تابع
سختگيري است تا مطمئن شود كه شما از آن درست استفاده ميكنيد و
نتايج صحيحي ميگيريد.
تابع utf8_decode ممكن است گمراه كننده باشد. اين تابع UTF-8 را به ISO-8859-1 تبديل ميكند. هر كاراكتري كه در ISO-8859-1 موجود نيست (مثل سيريليك، يوناني، تايلندي و نظاير اينها) به علامت سوال تبديل ميشوند. اين گمراه كننده است به دليل اينكه ممكن است شما انتظار بيشتري را از اين تابع داشته باشيد اما بهتر از اين نميتواند كاري انجام دهد.
خلاصه
اين نوشته به شدت بر روي اعداد تكيه كرده و سعي كرده تا همه امكانات را به كار بگيرد. اميدوارم درك جامعي از مجموعههاي كاراكتري، يونيكد، UTF-8 و مشكلات مختلفي كه ميتوانند به وجود آيند را فراهم كرده باشد. مفاهيم داستان عبارتند از:
- شما به منظور درك متن غير لاتين نياز به شناخت مجموعه كاراكتري داريد
- به صورت داخلي، مرورگرها از يونيكد براي نمايش كاراكترها استفاده ميكنند
- اطمینان حاصل کنید كه همه صفحههاي وبتان UTF-8 را به عنوان مجموعه كاراكتري مشخص كردهاند
برای رویکردي متفاوتی به این موضوع، این مقاله 2003 درباره مجموعه کاراکتري عالی است. با تشكر از شما براي همراهيتان با اين سفر حماسي.
در انتها لينك چند سايت مفيد براي يونيكد:
يونيكد تصويري : http://unicodinator.com/
سايتي براي كاراكترهاي ♥، اعداد و علائم نقطه گذاري: http://graphemica.com/
كاوش يونيكد: http://unicode.martinleopold.com/
منبع:
http://coding.smashingmagazine.com/2012/06/06/all-about-unicode-utf8-character-sets/
اميدوارم ترجمه اين مقاله براي عزيزان مفيد بوده و توانسته باشد به پاسخهايتان درباره يونيكد و مجموعههاي كاراكتري كه معمولاً اطلاعات كمتري درباره آنها به زبان پارسي منتشر شده است، جواب بدهد. در ترجمه اصطلاحات و كلمات دشوارتر و نامأنوستر سعي شده بهترين معادل آنها كه با متن هماهنگي لازم را داشته باشد بكار گرفته شود و خود عبارت انگليسي هم داخل پرانتز ذكر شده تا خواننده متوجه شود كه ترجمه ذكر شده مربوط به چه عبارتي است. باعث خوشحالي خواهد بود كه ما را از نظرات خوب و سازنده خود محروم نفرماييد و اگر مطلب يا بحث تكميلي در اين باره داريد يا ترجمههاي مناسبتري در مورد عبارات گفته شده به ذهن شما ميرسد در بخش نظرات مطرح نماييد.